A fondo
¿Se puede clonar tu propia voz y que lea bien?
Una de las dos voces del principio no la grabé yo. Y la que te habla en todo el video tampoco: es mi voz clonada con inteligencia artificial.
Miralo en
01De qué trata
Una de las dos voces del principio del video no la grabé yo. Y la que te habla todo el tiempo tampoco: es mi voz clonada con inteligencia artificial, con un modelo que se llama OmniVoice.
Vemos tres cosas: qué hace falta para clonar una voz, qué pasa si lo hacés en una compu común (y dónde lo hago yo) y cómo hacer que lea bien nombres, siglas y números.
No soy experto en voces: lo aprendí haciéndolo. Lo que ves son mis archivos, mis pruebas y mis tiempos reales. Lo que no pude confirmar, te lo digo.
Capítulos
- 0:00 · ¿A o B? Una de estas voces no la grabé yo
- 0:54 · Parte 1 · Qué es clonar una voz
- 1:54 · Parte 1 · La referencia manda
- 2:59 · Parte 2 · Hacerlo en tu compu
- 4:36 · Parte 2 · Dónde lo hago yo: Colab
- 5:13 · Parte 3 · Por qué lee mal y cómo se arregla
- 9:01 · Parte 3 · Pulido y velocidad
- 9:33 · Para llevarte
02Qué es clonar una voz
Un modelo de voz es un programa que aprendió a hablar después de procesar muchísimo audio. El que uso es OmniVoice, y se comparte en Hugging Face, un sitio donde se publican modelos.
Según su página oficial, convierte texto en voz, funciona con más de 600 idiomas (el español está en la lista) y puede clonar una voz a partir de un audio corto.
Clonar es esto: le das un audio de una persona hablando y un texto, y el modelo lee ese texto con esa voz. No repite el audio: lo imita para decir otra cosa.
- Un audio tuyo: los autores recomiendan una referencia de 3 a 10 segundos. Uno más largo hace el proceso más lento y puede empeorar el parecido.
- Un texto para que lea.
- Una computadora que corra el modelo.
- Referencia
- El audio corto de la voz que el modelo va a copiar.
Yo clono mi propia voz. Clonar la de otra persona sin que lo sepa y lo permita no se hace.
03La referencia manda
Mi primera referencia la grabé con gripe. Un clon copia todo lo de la referencia: si la voz de origen está apagada, el clon sale apagado; si aspira las eses, el clon también.
El 25 de octubre grabé cuatro tomas de nuevo, ya descansado. Elegí la cuarta y la recorté a casi nueve segundos, bien limpia. Esa es la que uso desde entonces.
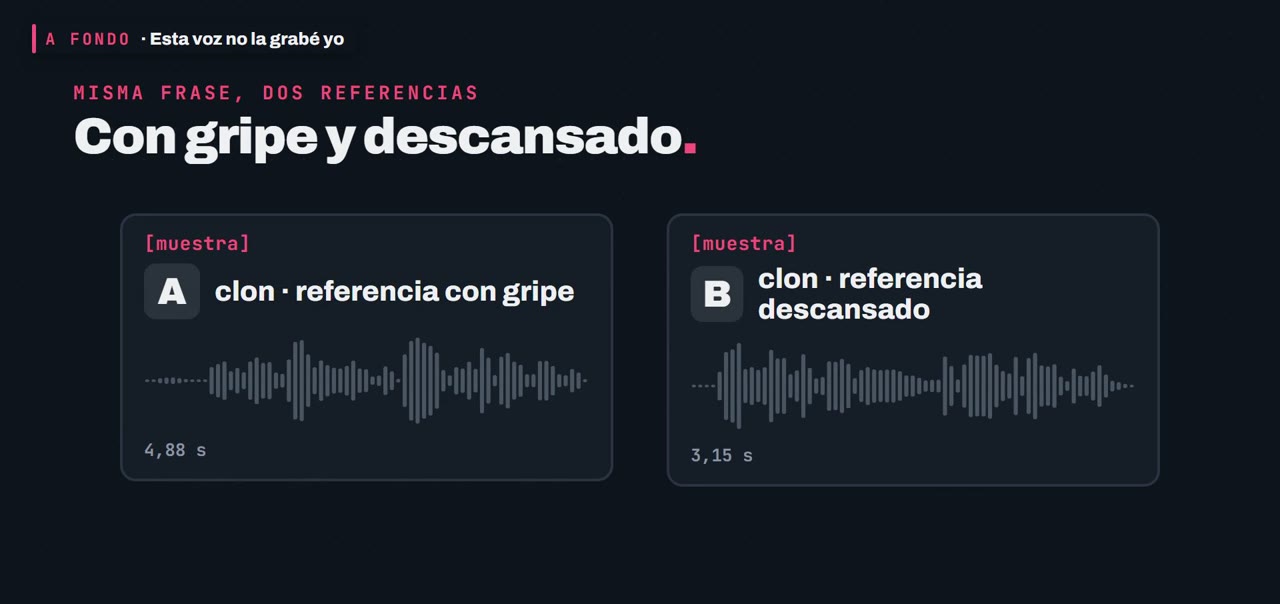
También probé con un corte de 3 segundos, el mínimo que recomiendan. Las dos versiones se entienden y dicen lo mismo, y sigo con la de casi nueve segundos porque es la que probé en todos mis videos. La referencia entera no la muestro: es la llave de mi clon.
04Hacerlo en tu compu
Se puede, lo hice en la mía, con Windows. Hace falta Python, una carpeta aparte para instalarlo (un entorno virtual) y el modelo, que se descarga una vez. Después el programa tiene menos de 30 líneas: le pasás el texto y la referencia y te devuelve un audio.
El 9 de noviembre hice la prueba: doce frases cortas, 45 segundos de audio en total. Las horas de los archivos dicen que tardó cerca de una hora, más o menos cinco minutos por frase.
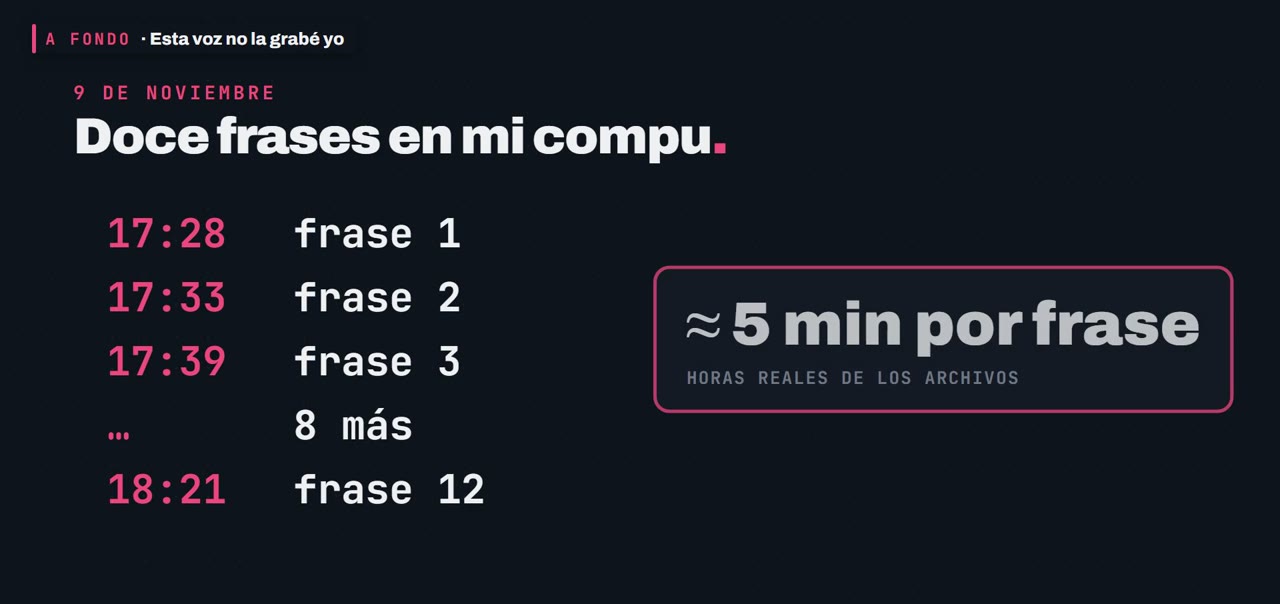
¿Por qué tan lento? El procesador hace las cuentas de a poco. Estos modelos se pensaron para la placa de video (GPU), que hace miles de cuentas a la vez. Las instrucciones oficiales explican cómo instalarlo para placas de video; para el procesador solo, no dicen nada.
Mi placa de video es vieja y tiene 2 GB de memoria. Una prueba anterior tardó ocho minutos por frase y, con el navegador abierto, el programa a veces se quedaba sin memoria. Es un error real que tuve.
05Dónde lo hago yo: Colab
Lo hago en computadoras prestadas, con placa de video. Una de ellas es Colab, un servicio de Google donde corrés programas en computadoras de Google, desde el navegador y sin instalar nada. Tiene una versión gratis y puede darte una placa de video.
Gratis tiene condiciones. Google aclara que los recursos no están garantizados, que los límites no se publican y que si te quedás inactivo, se corta. Por eso mi regla es no dejarlo esperando: se desconecta y se pierde todo.
No traigo cifras de límites ni de precios de Colab: no pude confirmarlos y cambian. Lo que dice Google en sus preguntas frecuentes está en las fuentes.
06Por qué lee mal y cómo se arregla
Un modelo de voz no entiende lo que lee: mira las letras y adivina cómo suenan, según lo que más escuchó. Con palabras en inglés, nombres de marcas o números, adivina mal. No es un fallo raro: es lo normal.
La regla es una sola: escribir cada palabra como la diría una persona al leerla en voz alta. La corrección es solo para la voz; en pantalla va la ortografía normal.
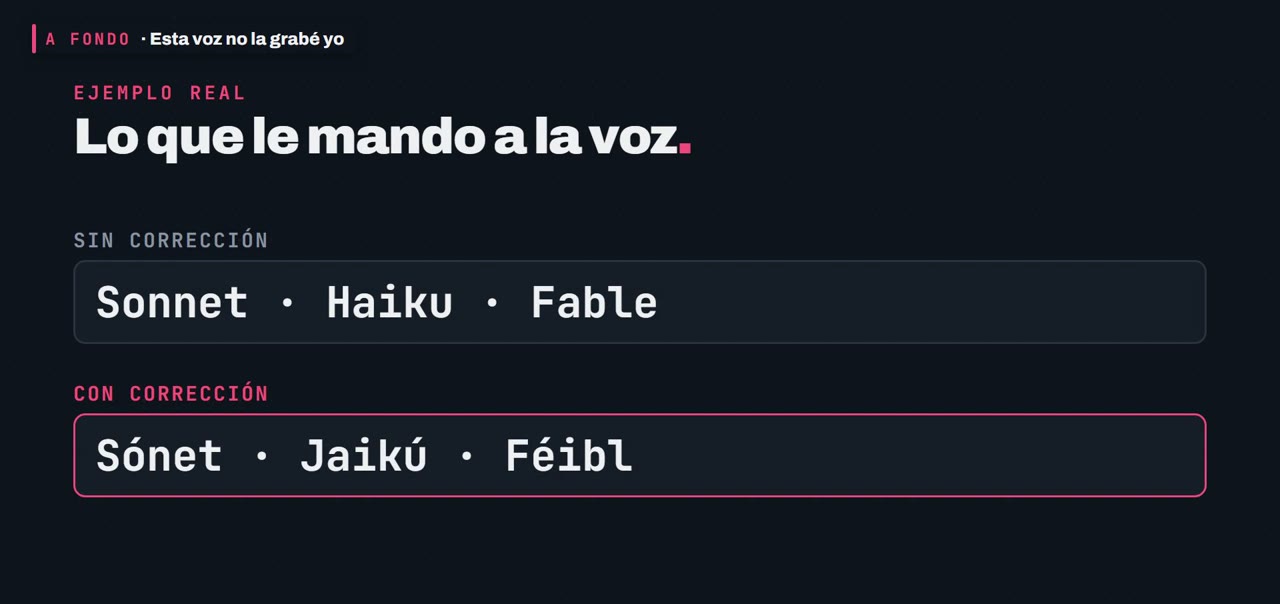
- Siglas: las escribo con el nombre de cada letra. Para API escribo "a pi".
- Números: el programa que uso en Colab solo lee bien enteros sueltos, así que los paso a letras antes de generar el audio.
- La letra ge antes de e o i: en "imágenes" la leía raro; la solución fue escribir "imájenes". Con la sigla GPT, deletrearla sonó como "yepeyé" y funcionó escribirla tal cual.
- Las eses del final son lo más difícil: a veces la voz se las come, sobre todo si acelero. No hay forma de forzarla escribiendo distinto; se escucha y se repite.
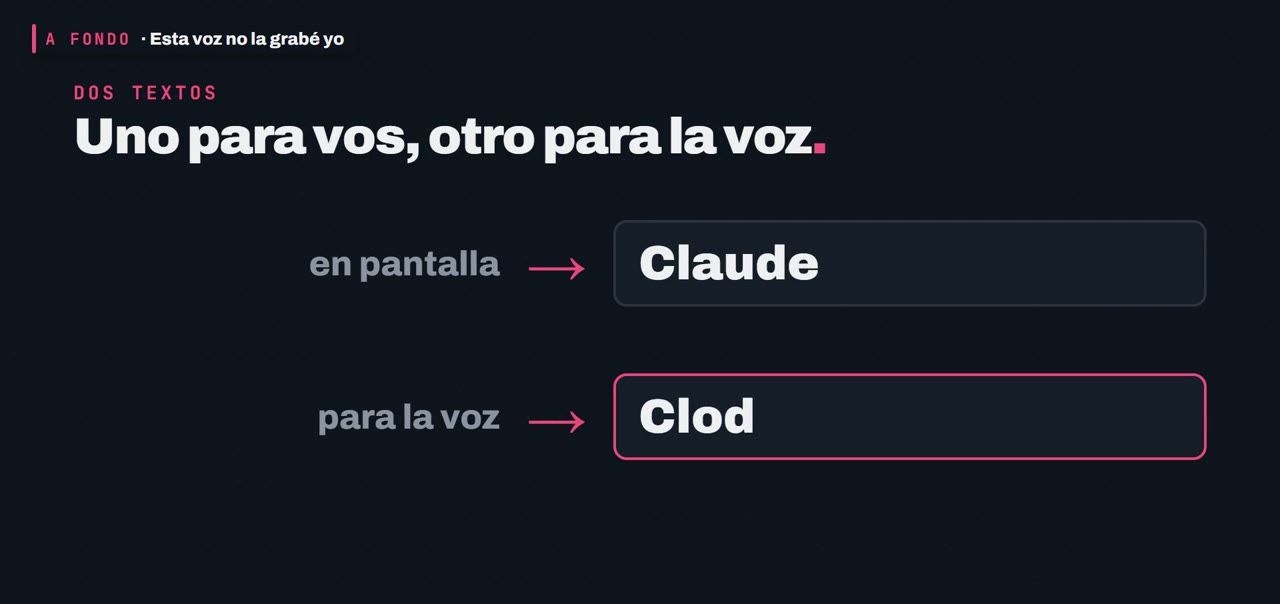
Todas esas reglas viven en un archivo de texto, un diccionario: de un lado cómo se escribe cada palabra y del otro cómo se dice. Un programa mío reemplaza cada palabra antes de mandar el texto a la voz y deja intacto lo que va en pantalla.
No está terminado: cada vez que algo suena mal, agrego una línea. Para no depender solo de mi oído, otro programa le manda cada frase a una inteligencia artificial que escucha y dice qué entendió. Un caso real: una frase decía "hay plan gratis" y esa IA escuchó "ay plan gratis".
El método, para lo tuyo
- Generá una frase con tus palabras.
- Escuchala.
- Anotá las que suenan mal.
- Reescribilas como se dicen y probá de nuevo.
- Guardalas en una lista: es tu diccionario y sirve para el próximo audio.
Una cosa más: si repetís la misma frase, el resultado cambia un poco cada vez. Por eso genero frases cortas y elijo la mejor.
07Pulido y velocidad
Estos modelos entregan el audio bajo. Un programa mío corta los graves que embarran, suma claridad y nivela el volumen.
El modelo acepta un número de velocidad y 1 es lo normal. Antes, en los reels, usaba 1,12; ahora uso 1 en todo, con pausas reales entre frases. Con más velocidad, lo primero que se pierde es la ese del final.
08Para llevarte
La respuesta del principio: de las dos primeras muestras, la que no grabé yo fue la B. La A es un pedazo de una grabación mía de octubre.
- Un clon se hace con un audio corto y un texto.
- La referencia manda.
- Los nombres, siglas y números se escriben como se dicen.
- Todo se escucha antes de usarlo.
Sirve para quien hace videos, clases o una aplicación que habla y quiere su propia voz sin grabar cada frase.
Este contenido usa voz clonada con IA. La única grabación real de mi voz es la muestra A del principio, un corte de una toma del 25 de octubre.
El próximo A fondo es Colab y sus alternativas gratis: la misma voz en dos máquinas, con los tiempos medidos. Contame en los comentarios qué tema querés que explique a fondo.
09Fuentes
Las páginas oficiales donde leí cada dato, con la fecha en que las vi.
- OmniVoice: página del modelo en Hugging Facehuggingface.co/k2-fsa/OmniVoice
- OmniVoice: repositorio (referencia de 3 a 10 segundos, instalación para placas NVIDIA, Apple e Intel Arc)github.com/k2-fsa/OmniVoice
- OmniVoice: lista de idiomasgithub.com/k2-fsa/OmniVoice/blob/main/docs/languages.md
- Colab: preguntas frecuentesresearch.google.com/colaboratory/intl/es-419/faq.html
- Kaggle: documentación de notebookskaggle.com/docs/notebooks
Seguí con
Newsletter
Lo nuevo que pruebo, explicado simple, directo a tu mail. Sin spam y te das de baja cuando quieras.